
 ventuari
Tutoriales / Errores
User memory limit exceeded en Google Earth Engine: por qué ocurre y cómo resolverlo
Qué significa el error User memory limit exceeded en Google Earth Engine, qué lo provoca y cómo resolverlo. Medimos cuánto cómputo cuesta cada arreglo con el mismo script en los 30 municipios de Córdoba (Colombia): tileScale 16 consumió casi seis veces más, con el mismo resultado.
Qué significa User memory limit exceeded
Earth Engine no ejecuta tu script en un solo computador. Divide el cálculo en muchas piezas, por ejemplo teselas de la imagen o grupos de elementos de una colección, y las reparte entre sus servidores. Cada pieza tiene un límite de memoria. Cuando una sola necesita más de lo permitido, el cálculo completo se detiene con User memory limit exceeded, como explica la guía de depuración de Earth Engine.
No tiene que ver con la memoria de tu computador ni con tu cuota, y no se amplía pagando: es un límite fijo de la plataforma, según la página de cuotas. Depende del tipo de petición: una tarea de exportación dispone de más memoria que una tesela del mapa. Por eso un cálculo que falla al verlo en el mapa puede terminar al exportarlo.
El error casi nunca significa que el análisis sea imposible, sino que alguna pieza quedó demasiado grande. La solución es cambiar cómo se reparte el trabajo, y cada forma de hacerlo tiene un costo que medimos más abajo.
Qué provoca el error de memoria en Earth Engine
- Reducciones sobre áreas grandes a escala fina.
reduceRegionoreduceRegionssobre un departamento entero a 10 m acumulan millones de píxeles en cada pieza. - Traer datos al cliente.
print(),getInfo()otoList()sobre colecciones grandes obligan a juntar todo en un solo lugar. - Colecciones sin filtrar. Aplicar
map()a una colección completa, con todas sus bandas, antes de filtrar por área, fechas y bandas. - Series temporales largas en arrays.
toArray()oiterate()sobre cientos de imágenes crean objetos enormes por píxel. - Vectorizar y unir en grande.
reduceToVectors,ee.Joiny geometrías con miles de vértices sobre áreas extensas. reproject()a una escala más fina que la necesaria. Obliga a calcular a esa resolución aunque la salida pida otra, y multiplica el trabajo de cada pieza.
Siete arreglos, empezando por los que no cuestan cómputo
Ninguno cambia el resultado si se aplica bien, pero no todos cuestan lo mismo. Los dos primeros reducen el trabajo y el tercero lo pasa a una tarea sin el límite de cinco minutos. tileScale, en cambio, reparte el mismo trabajo en más piezas y lo encarece.
1. Filtra y selecciona antes de mapear
Aplica filterBounds, filterDate y select lo antes posible. Cada banda y cada imagen que no se usa ocupa memoria en todas las piezas del cálculo. En nuestra prueba, quedarse con B4, B8 y SCL antes de la mediana bajó el cómputo un 11 % y el tiempo de la tarea un 39 %.
2. Usa la escala del dato
Calcula a la resolución real del producto que usas: 10 o 20 m en Sentinel-2, 30 m en Landsat o en JRC Global Surface Water. El tutorial de cuerpos de agua con MNDWI, por ejemplo, calcula a 20 m, la resolución de la banda SWIR de Sentinel-2. Pedir una escala más fina no aporta información y multiplica los píxeles; la guía de escala de Earth Engine explica por qué.
Cuidado con bestEffort: true: cuando la región tiene más píxeles que maxPixels, Earth Engine sube la escala por su cuenta. El cálculo puede terminar, pero a otra resolución y con otras cifras. Sirve para explorar, no para un informe.
3. Exporta en lugar de imprimir
print(), getInfo() y los gráficos son peticiones interactivas: deben terminar en cinco minutos, según la guía de entornos de procesamiento. En nuestra prueba, las versiones que no llegaron se cortaron a los 300,5 y 301,6 segundos con Computation timed out.
Una tarea de Export.table.toDrive o Export.image.toDrive corre en segundo plano y puede durar hasta diez días. Es la forma correcta de sacar resultados de áreas grandes.
4. Sube tileScale, de a poco
reduceRegion, reduceRegions, sample, sampleRegions y reduceToVectors aceptan el parámetro tileScale. Con 2, 4, 8 o 16, Earth Engine parte el cálculo en piezas más pequeñas, y cada pieza usa menos memoria. El resultado no cambia: en nuestra prueba, el NDVI de los 30 municipios coincidió hasta el décimo decimal.
No es gratis. Con tileScale 4, la exportación tardó menos de la mitad, pero consumió un 33 % más de cómputo. Con 16 consumió casi seis veces más y tardó más del doble (detalle). Empieza por 2 o 4, y sube solo si el error sigue.
5. Deja el trabajo en el servidor
Evita los bucles for del lado del cliente que llaman a getInfo() en cada vuelta, y las conversiones a lista con toList(). Usa map() sobre la colección y reduce al final.
6. Divide el problema
Si nada de lo anterior basta, procesa por partes: un año por tarea, un municipio por tarea o el área dividida en una grilla, por ejemplo con geometry.coveringGrid(). Después se unen los resultados. Es la solución que más tiempo ahorra en procesos multitemporales grandes.
7. Quita reproject() y recortes innecesarios
En la mayoría de los scripts reproject() sobra: Earth Engine elige la proyección según la salida. En las reducciones tampoco hace falta clip(): basta con pasar la geometría. Las dos recomendaciones están en la guía de buenas prácticas de Earth Engine. Pero no esperes que quitarlos resuelva el error: en nuestra prueba, la versión que los tenía no consumió más.
El experimento: el mismo cálculo en cinco versiones
Este script calcula el NDVI medio de 2024 de cada municipio de Córdoba (Colombia), con la mediana de Sentinel-2 a 10 m y reduceRegions. Es el tipo de cálculo en que más aparece el error.
Lo hace en cinco versiones, cada una con un solo cambio respecto de la anterior. La v1 es el script típico sin corregir; la v3 selecciona las bandas; la v4 y la v5 suben tileScale. Cada versión corre en modo interactivo y como exportación. Los municipios salen de GAUL 2025, que reemplaza a la capa de 2015, obsoleta en el catálogo.
Pulsa Run y después RUN en las cinco tareas memoria_… de la pestaña Tasks. Cuando terminen, cambia READ_TASKS a true y vuelve a ejecutar para ver el consumo de cada una.
/**
 * Experiment: what actually fixes "User memory limit exceeded"?
 *
 * Same calculation in five versions, from the typical naive script to the
 * corrected one, changing one thing at a time:
 *
 *     mean NDVI of 2024 (Sentinel-2 median, 10 m) for each municipality of
 *     Córdoba, Colombia, with reduceRegions.
 *
 * Each version runs twice:
 *     1. interactive (evaluate), where the error usually shows up: this
 *        script times each one and prints the result in the console;
 *     2. as an export task: click RUN on the five "memoria_..." tasks in the
 *        Tasks tab. When they finish, set READ_TASKS = true and run the script
 *        again to read their runtime and EECU-seconds.
 *
 * Keep this tab open until the console prints "Done". The interactive runs go
 * one after another and can take up to 25 minutes.
 */


/**
 * Settings
 */
var START = '2024-01-01';
var END = '2025-01-01';            // filterDate excludes END
var CRS = 'EPSG:32618';            // UTM 18N, the zone of Córdoba
var SCALE = 10;                    // Sentinel-2 B4 and B8
var DRIVE_FOLDER = 'earthengine';
var READ_TASKS = false;            // true: only read the finished exports


/**
 * Data
 *
 * GAUL 2025: GAUL 2015 is deprecated in the Earth Engine catalog and misses
 * the newer municipalities of Córdoba.
 */
var municipalities = ee.FeatureCollection('FAO/GAUL/2025/level2')
    .filter(ee.Filter.eq('ISO3_CODE', 'COL'))
    .filter(ee.Filter.inList('GAUL1_NAME', ['Córdoba', 'Cordoba']));

print('Polygons', municipalities.size());
print('Names', municipalities.aggregate_array('GAUL2_NAME').distinct().sort());

var region = municipalities.geometry();
Map.centerObject(municipalities, 8);
Map.addLayer(municipalities, {color: 'black'}, 'Municipalities');

var s2 = ee.ImageCollection('COPERNICUS/S2_SR_HARMONIZED')
    .filterBounds(region)
    .filterDate(START, END);

// SCL classes removed: 0 no data, 1 saturated, 3 cloud shadow,
// 8 and 9 cloud (medium and high probability), 10 cirrus.
var SCL_BAD = [0, 1, 3, 8, 9, 10];

function maskScl(image) {
  var bad = image.select('SCL').remap(SCL_BAD, SCL_BAD.map(function () { return 1; }), 0);
  return image.updateMask(bad.not());
}

// Median NDVI of the year. selectFirst keeps only B4, B8 and SCL before the
// median; otherwise the median runs over every band.
function ndviImage(selectFirst) {
  var collection = selectFirst ? s2.select(['B4', 'B8', 'SCL']) : s2;
  return collection.map(maskScl).median()
      .normalizedDifference(['B8', 'B4'])
      .rename('NDVI');
}


/**
 * Versions: each one changes a single thing from the previous one
 */
var VERSIONS = [
  {
    key: 'v1_ingenuo',
    label: 'Todas las bandas, clip() y reproject(), tileScale 1',
    // What a typical script (or an AI assistant) writes: every band,
    // clip() to the region and reproject() "to fix the scale".
    image: function () { return ndviImage(false).clip(region).reproject({crs: CRS, scale: SCALE}); },
    tileScale: 1
  },
  {
    key: 'v2_sin_clip',
    label: 'Sin clip() ni reproject()',
    image: function () { return ndviImage(false); },
    tileScale: 1
  },
  {
    key: 'v3_bandas',
    label: 'Solo B4, B8 y SCL antes de la mediana',
    image: function () { return ndviImage(true); },
    tileScale: 1
  },
  {
    key: 'v4_tilescale4',
    label: 'Lo anterior y tileScale 4',
    image: function () { return ndviImage(true); },
    tileScale: 4
  },
  {
    key: 'v5_tilescale16',
    label: 'Lo anterior y tileScale 16',
    image: function () { return ndviImage(true); },
    tileScale: 16
  }
];

function perMunicipality(version) {
  return version.image().reduceRegions({
    collection: municipalities,
    reducer: ee.Reducer.mean(),
    crs: CRS,
    scale: SCALE,
    tileScale: version.tileScale
  }).select(['GAUL2_NAME', 'mean']);
}


/**
 * 1. Exports: they appear in the Tasks tab. Click RUN on each one.
 */
VERSIONS.forEach(function (version) {
  if (READ_TASKS) return;
  Export.table.toDrive({
    collection: perMunicipality(version),
    description: 'memoria_' + version.key,
    folder: DRIVE_FOLDER,
    fileFormat: 'CSV'
  });
});


/**
 * 2. Interactive runs, one at a time
 *
 * From the corrected version to the naive one: if Earth Engine reuses any
 * cached piece, the advantage goes to the naive versions, not to the fixes.
 */
var order = VERSIONS.slice().reverse();
var rows = [];
var values = {};    // key -> {municipality: mean NDVI}

function runNext(i) {
  if (i >= order.length) {
    showTables();
    return;
  }
  var version = order[i];
  var t0 = Date.now();
  print('Running ' + version.key + '…');
  perMunicipality(version).evaluate(function (result, error) {
    var seconds = Math.round((Date.now() - t0) / 100) / 10;
    var state = error ? 'FAILED' : 'COMPLETED';
    if (!error) {
      values[version.key] = {};
      result.features.forEach(function (f) {
        values[version.key][f.properties.GAUL2_NAME] = f.properties.mean;
      });
    }
    print(version.key + ': ' + state + ', ' + seconds + ' s' + (error ? ' · ' + error : ''));
    rows.push([version.key, version.label, state, seconds, error || '']);
    runNext(i + 1);
  });
}


/**
 * 3. Results as tables: open each one with the arrow (↗) at its top right
 *    and download it as CSV.
 */
function showTables() {
  // Interactive runs, in the order of VERSIONS
  rows.sort(function (a, b) { return a[0] < b[0] ? -1 : 1; });
  var runs = {
    cols: [
      {label: 'version', type: 'string'},
      {label: 'cambio', type: 'string'},
      {label: 'estado', type: 'string'},
      {label: 'segundos', type: 'number'},
      {label: 'error', type: 'string'}
    ],
    rows: rows.map(function (r) {
      return {c: r.map(function (v) { return {v: v}; })};
    })
  };
  print(ui.Chart(runs, 'Table').setOptions({title: 'experimento_memoria_interactivo'}));

  // Mean NDVI per municipality of every interactive run that finished
  var keys = VERSIONS.map(function (v) { return v.key; })
      .filter(function (k) { return values[k]; });
  if (keys.length) {
    var names = Object.keys(values[keys[0]]).sort();
    var ndvi = {
      cols: [{label: 'municipio', type: 'string'}].concat(keys.map(function (k) {
        return {label: k, type: 'number'};
      })),
      rows: names.map(function (m) {
        return {c: [{v: m}].concat(keys.map(function (k) {
          return {v: values[k][m]};
        }))};
      })
    };
    print(ui.Chart(ndvi, 'Table').setOptions({title: 'ndvi_por_municipio'}));
  }
  print('Done');
}


/**
 * 4. Runtime and EECU-seconds of the exports (READ_TASKS = true)
 *
 * Run it when the five tasks have finished. If an export was launched more
 * than once, it takes the latest run.
 */
function readTasks() {
  ee.data.listOperations(100, function (ops, error) {
    if (error) {
      print('Error: ' + error);
      return;
    }

    // Latest run of each task, in case an export was launched more than once
    var latest = {};
    ops.forEach(function (op) {
      var m = op.metadata || {};
      if (!m.description || m.description.indexOf('memoria_') !== 0) return;
      if (!latest[m.description] || m.createTime > latest[m.description].metadata.createTime) {
        latest[m.description] = op;
      }
    });

    var rows = Object.keys(latest).sort().map(function (name) {
      var op = latest[name];
      var m = op.metadata;
      var end = m.endTime || m.updateTime;
      var seconds = m.startTime && end ?
          Math.round((Date.parse(end) - Date.parse(m.startTime)) / 100) / 10 : null;
      var error = op.error ? op.error.message : '';
      return {c: [
        {v: name.replace('memoria_', '')},
        {v: m.state},
        {v: seconds},
        {v: m.batchEecuUsageSeconds !== undefined ? Number(m.batchEecuUsageSeconds) : null},
        {v: error}
      ]};
    });

    if (!rows.length) {
      print('No "memoria_..." tasks found.');
      return;
    }

    print(ui.Chart({
      cols: [
        {label: 'version', type: 'string'},
        {label: 'estado', type: 'string'},
        {label: 'segundos', type: 'number'},
        {label: 'eecu_segundos', type: 'number'},
        {label: 'error', type: 'string'}
      ],
      rows: rows
    }, 'Table').setOptions({title: 'experimento_memoria_exportacion'}));
  });
}


if (READ_TASKS) {
  readTasks();
} else {
  runNext(0);
}
En Colab hace todo en una sola ejecución: lanza las exportaciones, mide las consultas interactivas, espera a las tareas y descarga dos CSV con los resultados.
"""
Experiment: what actually fixes "User memory limit exceeded"?

Same calculation in five versions, from the typical naive script to the
corrected one, changing one thing at a time:

    mean NDVI of 2024 (Sentinel-2 median, 10 m) for each municipality of
    Córdoba, Colombia, with reduceRegions.

Each version runs twice:
    1. interactive (getInfo), where the error usually shows up;
    2. as an export task, which reports its runtime and EECU-seconds.

Output: experimento_memoria.csv with one row per version and mode
(state, error message, seconds, EECU-seconds), plus the per-municipality
NDVI of every run that finished, to check that the fixes do not change the
numbers.

Run it in Colab or Jupyter. It takes between 20 and 60 minutes.
"""

import csv
import time

import ee

ee.Authenticate()
ee.Initialize(project='tu-proyecto-gcp')


# ---------------------------------------------------------------------------
# Settings
# ---------------------------------------------------------------------------

START, END = '2024-01-01', '2025-01-01'   # filterDate excludes END
CRS = 'EPSG:32618'                         # UTM 18N, the zone of Córdoba
SCALE = 10                                 # Sentinel-2 B4 and B8
DRIVE_FOLDER = 'earthengine'
OUTPUT_CSV = 'experimento_memoria.csv'
POLL_SECONDS = 30


# ---------------------------------------------------------------------------
# Data
# ---------------------------------------------------------------------------

# GAUL 2025: GAUL 2015 is deprecated in the Earth Engine catalog and misses
# the newer municipalities of Córdoba.
municipalities = (
    ee.FeatureCollection('FAO/GAUL/2025/level2')
    .filter(ee.Filter.eq('ISO3_CODE', 'COL'))
    .filter(ee.Filter.inList('GAUL1_NAME', ['Córdoba', 'Cordoba']))
)
print('Polygons:', municipalities.size().getInfo(),
      sorted(set(municipalities.aggregate_array('GAUL2_NAME').getInfo())))
region = municipalities.geometry()

s2 = (
    ee.ImageCollection('COPERNICUS/S2_SR_HARMONIZED')
    .filterBounds(region)
    .filterDate(START, END)
)

# SCL classes removed: 0 no data, 1 saturated, 3 cloud shadow,
# 8 and 9 cloud (medium and high probability), 10 cirrus.
SCL_BAD = [0, 1, 3, 8, 9, 10]


def mask_scl(image):
    scl = image.select('SCL')
    bad = scl.remap(SCL_BAD, [1] * len(SCL_BAD), 0)
    return image.updateMask(bad.Not())


def ndvi_image(select_first):
    """Median NDVI of the year. select_first keeps only B4, B8 and SCL
    before the median; otherwise the median runs over every band."""
    collection = s2.select(['B4', 'B8', 'SCL']) if select_first else s2
    median = collection.map(mask_scl).median()
    return median.normalizedDifference(['B8', 'B4']).rename('NDVI')


# ---------------------------------------------------------------------------
# Versions: each one changes a single thing from the previous one
# ---------------------------------------------------------------------------

def v1_naive():
    # What a typical script (or an AI assistant) writes: every band,
    # clip() to the region and reproject() "to fix the scale".
    return ndvi_image(False).clip(region).reproject(crs=CRS, scale=SCALE), 1


def v2_no_clip_reproject():
    return ndvi_image(False), 1


def v3_select_bands():
    return ndvi_image(True), 1


def v4_tilescale_4():
    return ndvi_image(True), 4


def v5_tilescale_16():
    return ndvi_image(True), 16


VERSIONS = [
    ('v1_ingenuo', 'Todas las bandas, clip() y reproject(), tileScale 1', v1_naive),
    ('v2_sin_clip', 'Sin clip() ni reproject()', v2_no_clip_reproject),
    ('v3_bandas', 'Solo B4, B8 y SCL antes de la mediana', v3_select_bands),
    ('v4_tilescale4', 'Lo anterior y tileScale 4', v4_tilescale_4),
    ('v5_tilescale16', 'Lo anterior y tileScale 16', v5_tilescale_16),
]


def per_municipality(version_fn):
    image, tile_scale = version_fn()
    return image.reduceRegions(
        collection=municipalities,
        reducer=ee.Reducer.mean(),
        crs=CRS,
        scale=SCALE,
        tileScale=tile_scale,
    ).select(['GAUL2_NAME', 'mean'])


# ---------------------------------------------------------------------------
# 1. Exports: start all of them now, they run in the background
# ---------------------------------------------------------------------------

tasks = {}
for key, _, fn in VERSIONS:
    task = ee.batch.Export.table.toDrive(
        collection=per_municipality(fn),
        description=f'memoria_{key}',
        folder=DRIVE_FOLDER,
        fileFormat='CSV',
    )
    task.start()
    tasks[key] = task
    print('Export started:', key)


# ---------------------------------------------------------------------------
# 2. Interactive runs, one at a time
#
# From the corrected version to the naive one: if Earth Engine reuses any
# cached piece, the advantage goes to the naive versions, not to the fixes.
# ---------------------------------------------------------------------------

rows = []
values = {}   # key -> {municipality: mean NDVI}

for key, label, fn in reversed(VERSIONS):
    print('Interactive:', key, '...', end=' ', flush=True)
    t0 = time.time()
    try:
        result = per_municipality(fn).getInfo()
        state, error = 'COMPLETED', ''
        values[key] = {
            f['properties']['GAUL2_NAME']: f['properties'].get('mean')
            for f in result['features']
        }
    except ee.EEException as e:
        state, error = 'FAILED', str(e)
    seconds = round(time.time() - t0, 1)
    print(state, seconds, 's', error[:80])
    rows.append({
        'version': key, 'cambio': label, 'modo': 'interactivo',
        'estado': state, 'error': error, 'segundos': seconds,
        'eecu_segundos': '',
    })


# ---------------------------------------------------------------------------
# 3. Wait for the exports and read their runtime and EECU usage
# ---------------------------------------------------------------------------

pending = set(tasks)
while pending:
    for key in sorted(pending):
        if tasks[key].status()['state'] in ('COMPLETED', 'FAILED', 'CANCELLED'):
            pending.discard(key)
    if pending:
        print('Exports still running:', ', '.join(sorted(pending)))
        time.sleep(POLL_SECONDS)

for key, label, _ in VERSIONS:
    status = tasks[key].status()
    start = status.get('start_timestamp_ms')
    end = status.get('update_timestamp_ms')
    seconds = round((end - start) / 1000, 1) if start and end else ''
    rows.append({
        'version': key, 'cambio': label, 'modo': 'exportacion',
        'estado': status['state'], 'error': status.get('error_message', ''),
        'segundos': seconds,
        'eecu_segundos': status.get('batch_eecu_usage_seconds', ''),
    })


# ---------------------------------------------------------------------------
# 4. Do the fixes change the numbers? Largest difference in mean NDVI
#    against the first version that finished interactively.
# ---------------------------------------------------------------------------

reference_key = next((k for k, _, _ in VERSIONS if k in values), None)
for row in rows:
    key = row['version']
    if row['modo'] == 'interactivo' and key in values and reference_key:
        ref = values[reference_key]
        diffs = [
            abs(v - ref[m]) for m, v in values[key].items()
            if v is not None and ref.get(m) is not None
        ]
        row['max_dif_ndvi_vs_' + reference_key] = round(max(diffs), 5) if diffs else ''


# ---------------------------------------------------------------------------
# Save
# ---------------------------------------------------------------------------

fields = ['version', 'cambio', 'modo', 'estado', 'segundos', 'eecu_segundos', 'error']
fields += sorted({f for r in rows for f in r} - set(fields))
with open(OUTPUT_CSV, 'w', newline='', encoding='utf-8') as f:
    writer = csv.DictWriter(f, fieldnames=fields)
    writer.writeheader()
    writer.writerows(rows)

with open('ndvi_por_municipio.csv', 'w', newline='', encoding='utf-8') as f:
    keys = [k for k, _, _ in VERSIONS if k in values]
    writer = csv.writer(f)
    writer.writerow(['municipio'] + keys)
    for m in sorted({m for k in keys for m in values[k]}):
        writer.writerow([m] + [values[k].get(m) for k in keys])

print('\nSaved', OUTPUT_CSV, 'and ndvi_por_municipio.csv')

# In Colab the local disk is deleted when the session ends: download both files.
try:
    from google.colab import files
    files.download(OUTPUT_CSV)
    files.download('ndvi_por_municipio.csv')
except ImportError:
    pass
for r in rows:
    print(f"{r['version']:16} {r['modo']:12} {r['estado']:10} "
          f"{r['segundos']!s:>8} s  {r['eecu_segundos']!s:>8} EECU-s  {r['error'][:60]}")
Cuidado con la cuota: la prueba completa consumió unas 144 EECU-horas, 82 de ellas solo en la v5.
Cinco versiones del mismo script: lo que cuesta cada arreglo
Ejecutamos el script el 16 de octubre de 2026 en el Code Editor. Las cinco exportaciones terminaron y dieron el mismo NDVI en los 30 municipios: de 0,52 en Ayapel a 0,76 en Tierralta.
Ninguna versión llegó a User memory limit exceeded. El límite que apareció fue el de tiempo de las consultas interactivas. Lo que el experimento mide, por tanto, es cuánto cuesta cada arreglo cuando se aplica por precaución, sin que haga falta.
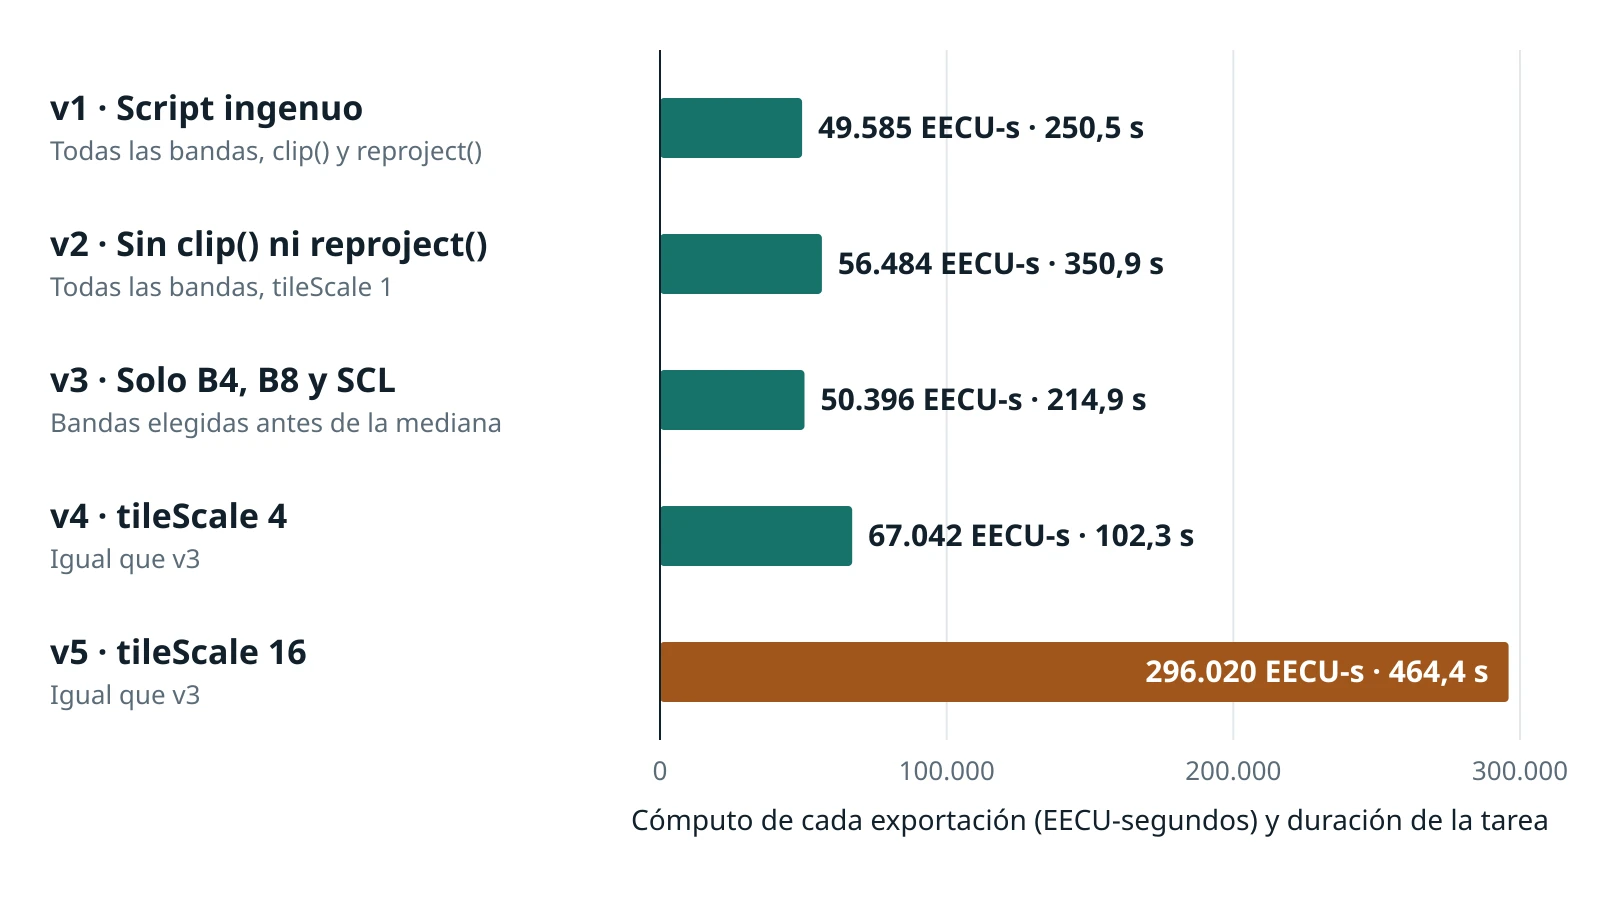
tileScale.Cada versión cambia una sola cosa, así que la tabla compara cada una con la anterior:
| Versión | Cambio | Cómputo (EECU-s) | Duración | Frente a la anterior |
|---|---|---|---|---|
| v1 | Script típico: todas las bandas, clip(), reproject() y tileScale 1 | 49.585 | 250,5 s | — |
| v2 | Sin clip() ni reproject() | 56.484 | 350,9 s | +14 % de cómputo |
| v3 | Solo B4, B8 y SCL antes de la mediana | 50.396 | 214,9 s | −11 % de cómputo y −39 % de tiempo |
| v4 | tileScale 4 | 67.042 | 102,3 s | +33 % de cómputo y −52 % de tiempo |
| v5 | tileScale 16 | 296.020 | 464,4 s | 4,4 veces el cómputo de v4 y 5,9 el de v3 |
tileScale 16 consumió casi seis veces más
La v3, la v4 y la v5 tienen el mismo código; solo cambia tileScale. Con 4, la tarea tardó menos de la mitad, pero consumió un 33 % más. Con 16 consumió casi seis veces más que con 1 y tardó más del doble. Partir el cálculo en más piezas no siempre lo acelera, y en nuestra prueba siempre lo encareció.
El cómputo se mide en EECU-segundos, la unidad con que Earth Engine registra el consumo de las tareas. No equivale a tiempo de reloj, según la descripción del cómputo de Earth Engine: la v5 sumó unas 82 EECU-horas en menos de ocho minutos. En un proyecto comercial, que paga por cómputo, esa diferencia llega a la factura.
Seleccionar bandas ahorró; quitar clip() y reproject(), no
Quedarse con B4, B8 y SCL antes de la mediana (v3) bajó el cómputo un 11 % y el tiempo un 39 % frente a la v2, que calcula la mediana de todas las bandas. Es el arreglo más fácil de aplicar y no tiene contras.
Quitar clip() y reproject() (v2) no ahorró nada: consumió un 14 % más que la v1. Con una sola ejecución, esa diferencia puede ser variación normal entre tareas, pero muestra que no eran el problema. El reproject() de la v1 usaba la misma proyección y escala que la reducción, así que no añadía trabajo. Sí lo añade cuando fuerza una escala más fina que la necesaria.
La segunda ejecución engaña
Las consultas interactivas no sirven para comparar arreglos. La primera vez, la v5 se cortó a los 300,5 segundos y la v4, que corrió justo después, terminó en 7,3. La v2 también se cortó, y la v1 terminó después en 5 segundos. En una segunda ejecución terminaron las cinco, cuatro de ellas en menos de 8 segundos.
Earth Engine reutiliza resultados de cálculos anteriores, también parciales o intermedios, según la misma descripción del cómputo. La versión que corre primero paga el trabajo y las siguientes lo aprovechan. Para comparar dos versiones de un script, exporta cada una y compara su consumo en EECU, como hace el script con READ_TASKS.
Errores parecidos que no son de memoria
| Mensaje | Qué significa | Qué hacer |
|---|---|---|
Computation timed out | La consulta interactiva superó los cinco minutos | Exportar en lugar de imprimir o graficar |
Too many pixels in the region | La reducción supera maxPixels | Subir maxPixels o la escala |
Collection query aborted after accumulating over 5000 elements | print() de una colección con más de 5000 elementos | Imprimir un resumen (size(), first()) o exportar |
Too many concurrent aggregations | Demasiadas reducciones en paralelo en una consulta | Exportar o dividir en tareas |
Lo que la IA suele hacer mal
Si le pegas el error a un asistente de IA, estas son las respuestas que más aparecen y por qué no resuelven el problema:
- Pone
tileScale: 16de entrada. Sale caro: en nuestra prueba consumió casi seis veces más cómputo y tardó más del doble, con el mismo resultado. Se sube de a poco (2, 4, 8) y solo si el error aparece. - Sube
maxPixels.maxPixelsresuelve Too many pixels, no la memoria. Subirlo no cambia nada, o hace que la pieza sea aún más pesada. - Propone
bestEffort: truecomo solución. Ese parámetro sube la escala por su cuenta cuando la región superamaxPixels. El error puede desaparecer, pero las cifras cambian sin avisar y dejan de ser comparables. - Añade
reproject()para "fijar la escala". No resuelve la memoria. Si fuerza una escala más fina que la necesaria, multiplica el trabajo de cada pieza. - Resuelve con un bucle y
getInfo(). Mueve el trabajo al cliente: cada vuelta es una consulta interactiva, lenta y con su propio límite. - Recomienda pagar un plan más grande. La memoria por petición es un límite fijo de toda la plataforma: ningún plan la amplía. Hay que cambiar cómo se reparte el trabajo.
De 8 horas a una: dos procesos reales, divididos y en el servidor
Aplicando estas técnicas a procesos reales, en trabajos recientes una asignación mensual de focos de fuego pasó de 8 horas a una como máximo, y una clasificación supervisada multitemporal que tardaba 7 horas o más, o fallaba, pasó a correr en 2 horas como máximo. En ambos casos la clave fue dividir el problema y dejar el trabajo en el servidor, sin cambiar los resultados.
Preguntas frecuentes
¿Qué significa User memory limit exceeded en Google Earth Engine?
Que una de las piezas en que Earth Engine divide el cálculo necesitó más memoria de la permitida. No tiene que ver con la memoria de tu computador ni con tu cuota: el análisis está planteado de forma que alguna pieza queda demasiado grande.
¿Cómo se soluciona User memory limit exceeded?
Empieza por lo que no cuesta cómputo: selecciona solo las bandas que usas, calcula a la escala del dato y exporta en lugar de imprimir. Si el error sigue, sube tileScale de a poco (2, 4, 8) en reduceRegion, reduceRegions o sample. Si tampoco basta, divide el problema por años o por zonas.
¿Qué hace el parámetro tileScale?
Hace que Earth Engine divida el cálculo en piezas más pequeñas, que usan menos memoria. El resultado es el mismo, pero el cómputo sube: en una prueba con 30 municipios a 10 m, tileScale 16 consumió casi seis veces más que sin él.
¿Por qué un script de Earth Engine tarda menos la segunda vez?
Porque Earth Engine reutiliza resultados de cálculos anteriores, también los parciales. La primera ejecución paga el trabajo y las siguientes lo aprovechan. Para comparar dos versiones de un script, exporta cada una y compara su consumo en EECU, no los segundos de la consola.
¿Qué diferencia hay entre User memory limit exceeded y Computation timed out?
User memory limit exceeded es un problema de memoria de una pieza del cálculo. Computation timed out aparece cuando una consulta interactiva, como print() o getInfo(), no termina en cinco minutos. Los dos se suelen resolver exportando el resultado, porque una tarea puede durar hasta diez días.
Fuentes
- Debugging guideGoogle Earth Engine, documentaciónQué significan User memory limit exceeded y Computation timed out.
- Earth Engine quotasGoogle Earth Engine, documentaciónLa memoria por petición es un límite fijo de la plataforma y depende del tipo de petición: más para una tarea que para una tesela del mapa.
- Processing EnvironmentsGoogle Earth Engine, documentaciónLas peticiones interactivas deben terminar en cinco minutos; cada tarea puede durar hasta diez días.
- Computation OverviewGoogle Earth Engine, documentaciónQué es un EECU, por qué el EECU-tiempo no equivale a tiempo de reloj y la reutilización de resultados anteriores.
- Coding Best PracticesGoogle Earth Engine, documentaciónPor qué evitar
clip()en las reducciones yreproject()innecesario. - ScaleGoogle Earth Engine, documentaciónCómo elige Earth Engine la escala del cálculo.
- ee.Image.reduceRegionGoogle Earth Engine, referencia de la APIParámetros
tileScale,maxPixelsybestEffort. - FAO GAUL: Global Administrative Unit Layers 2025, Second-Level Administrative UnitsGoogle Earth Engine, catálogo de datosLímites municipales usados en el experimento; reemplaza a GAUL 2015, marcada como obsoleta.
- Harmonized Sentinel-2 MSI: MultiSpectral Instrument, Level-2A (SR)Google Earth Engine, catálogo de datosBandas B4, B8 y SCL usadas para el NDVI y la máscara de nubes.
Sigue aprendiendo
Vegetación · NDVI
Serie temporal de NDVI y fenología de cultivos en Google Earth EngineAgua · MNDWI
Cómo detectar cuerpos de agua con MNDWI y Google Earth EngineImágenes
Cómo hacer un mosaico Landsat sin nubes en Google Earth Engine
¿Tu script sigue sin terminar? Mira el servicio Análisis que por fin terminan.
¿Tienes un script de Earth Engine que se cae por memoria o tarda horas?
Escribe a contacto@ventuari.dev con el enlace de tu script y recibirás un diagnóstico con alcance y precio.